曲目搜索能返回结果,音频地址也能请求成功,播放器却不一定能出声。排查这条链路时,只看 HTTP 状态码不够,还要继续看容器结构、Sample 边界和输出格式。
这次研究汽水音乐的播放过程,我把代码分成了数据访问、容器解析、媒体处理和播放输出几层。下面记录各层负责的工作,以及实现时需要单独处理的边界。
播放链路的五个阶段
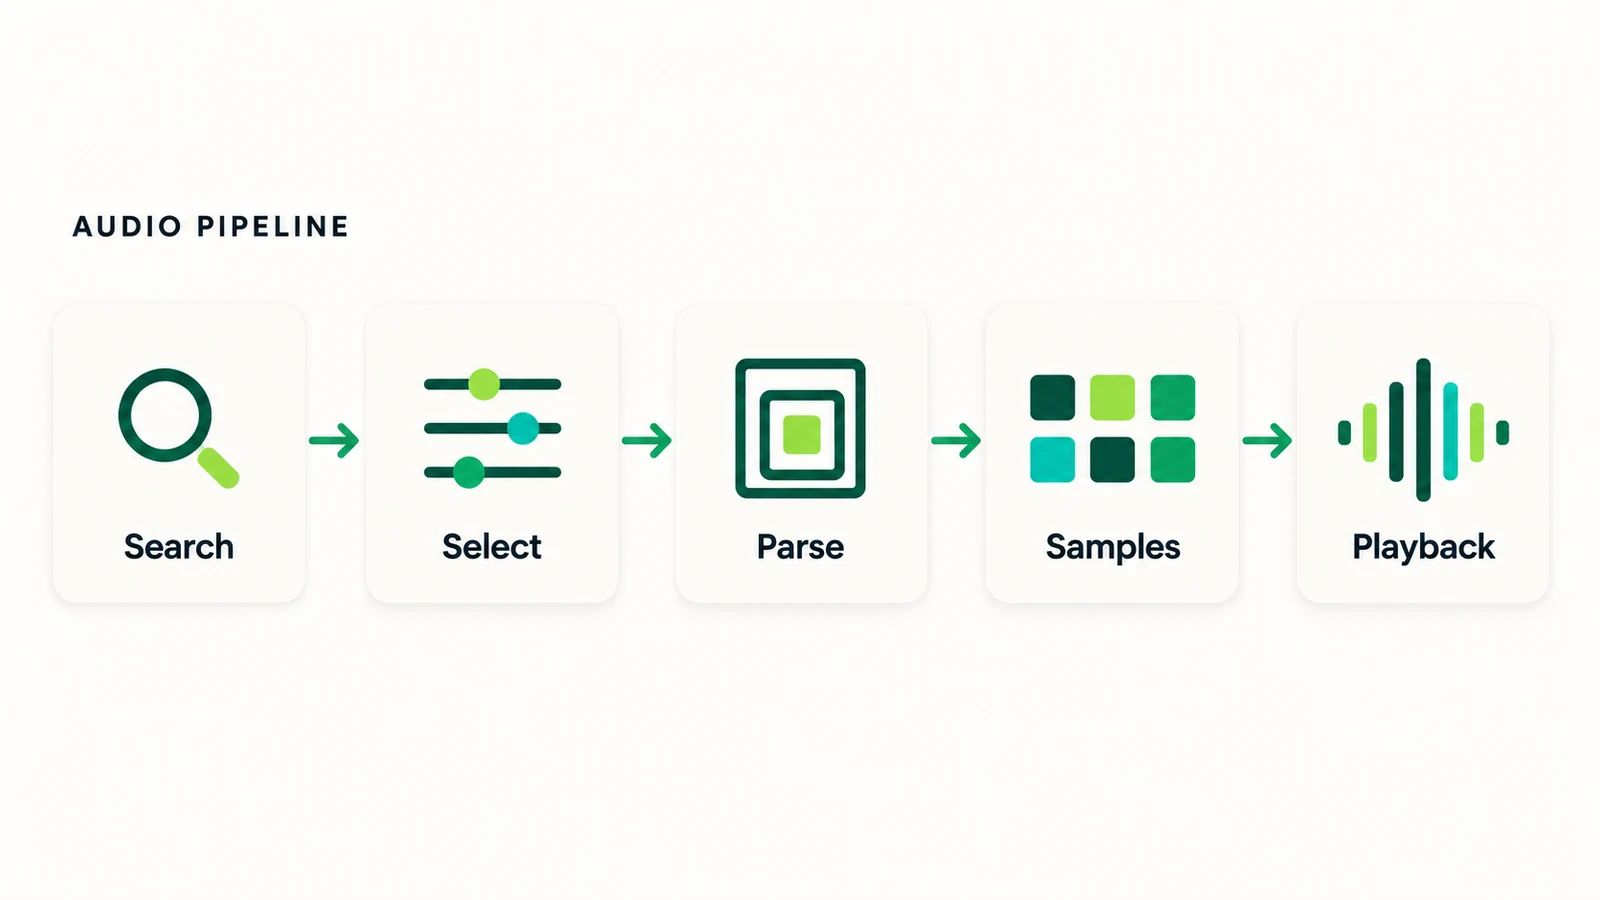
- 检索曲目:取得名称、作者、时长和资源标识等元数据。
- 选择资源:确定音质、码率及编码格式,把结果整理为统一的媒体资源对象。
- 解析容器:读取轨道、编码配置、Sample 表和媒体数据区位置。
- 处理 Sample:按索引切分数据,并与对应的辅助信息对齐。
- 输出播放:根据编码形式组装输出,将数据持续交给播放器。
搜索模块不负责播放,容器解析器也不需要知道用户在界面上选了什么。每层只接收约定好的数据,问题就容易缩小到具体位置。
先统一曲目数据
远端响应往往服务于客户端界面:字段嵌套较深,不同请求的结构也可能有差别。如果播放模块直接读取这些原始字段,接口的小变化就会影响后面的处理。
我在入口增加了一层归一化,只向后传递固定的曲目模型。下面保留模型和调用关系,read_* 是省略的字段映射函数:
from dataclasses import dataclass, field
@dataclass(slots=True)class TrackCandidate: id: str title: str artists: list[str] duration_ms: int qualities: list[str] = field(default_factory=list)
def normalize_track(raw: dict) -> TrackCandidate: """将远端响应收敛为播放链路唯一认识的曲目模型。""" return TrackCandidate( id=read_track_id(raw), title=read_title(raw), artists=read_artists(raw), duration_ms=read_duration(raw), qualities=read_available_qualities(raw), )后续模块只依赖 TrackCandidate。远端字段变了,调整映射层即可,不需要把搜索响应的细节带进整个播放器。
另外,资源可访问与资源可播放需要分开检查。200 说明请求成功,audio/mp4 是服务端声明的媒体类型;容器是否完整、编码配置是否齐全、音频帧能否解码,仍然需要继续验证。
通过 MP4 索引定位音频数据
MP4 是容器格式,由不同类型的 Box 组成。音频数据与描述它的结构信息通常放在不同位置,不能把响应体直接当作一串连续的音频帧。
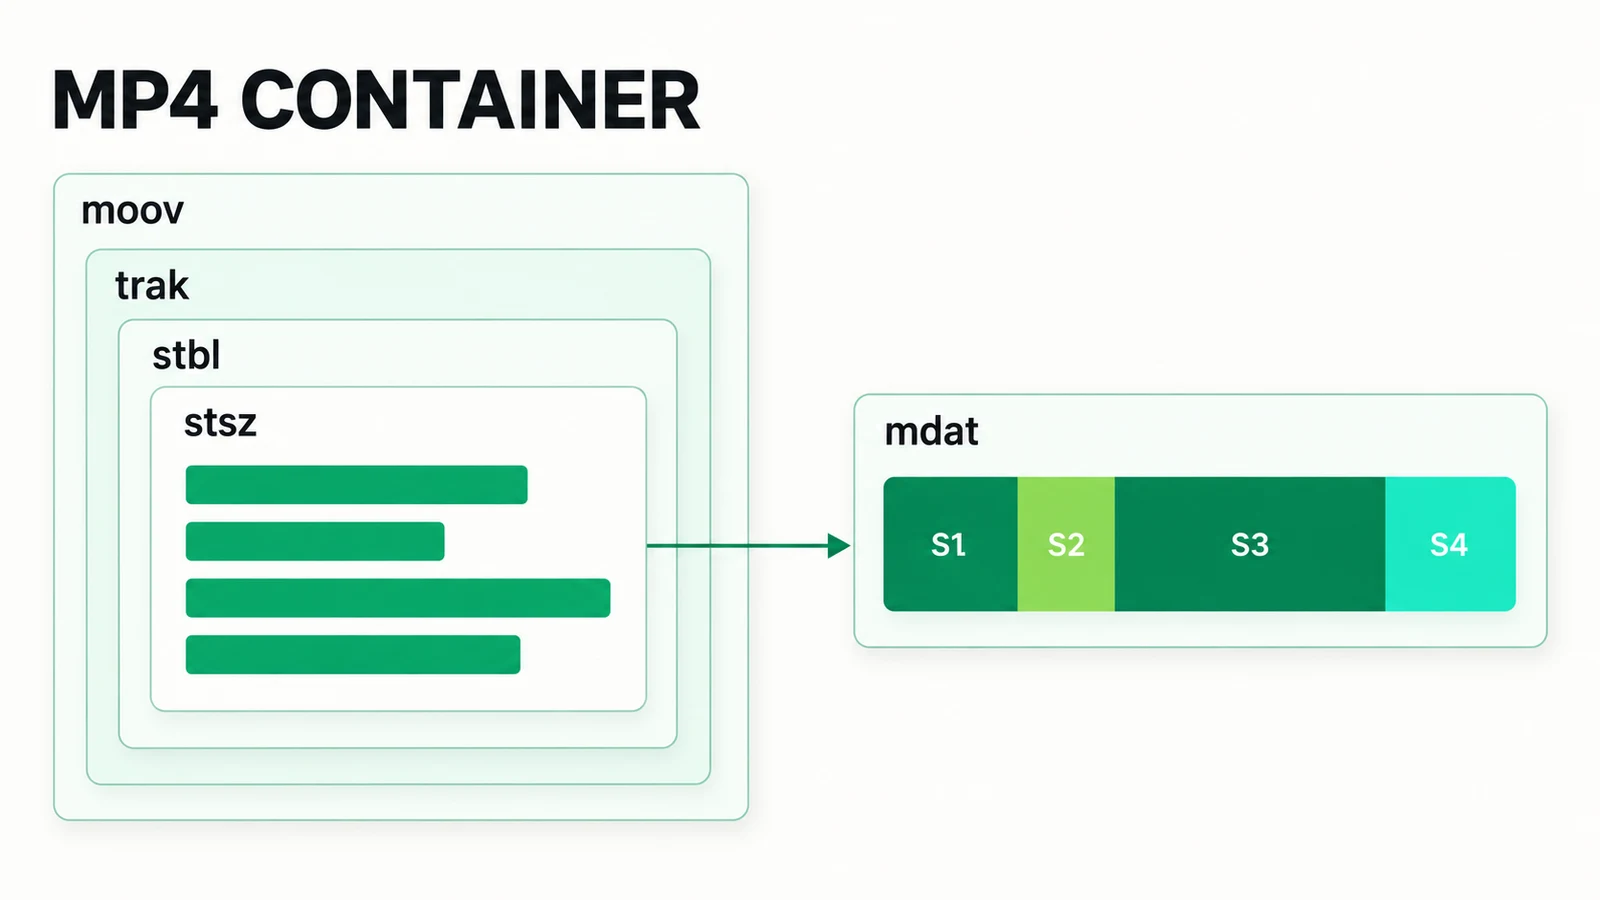
这次主要用到的结构包括:
moov:文件的媒体结构信息。trak:一条媒体轨道的描述。stbl:Sample 表相关结构的集合。stsz:各个 Sample 的大小。mdat:实际媒体数据。
Sample 是这里的媒体处理单元,与网络回调中的 Chunk 没有一一对应关系,长度也不一定相同。程序需要依据索引确定位置和大小,再读取对应的数据段。
下面是简化的 Box 遍历代码,展示普通长度和 64 位扩展长度的处理:
def iter_boxes(data: bytes): offset = 0
while offset + 8 <= len(data): size = int.from_bytes(data[offset : offset + 4], "big") kind = data[offset + 4 : offset + 8].decode("ascii", errors="replace") header_size = 8
# size == 1 表示 Box 使用 64 位扩展长度。 if size == 1: if offset + 16 > len(data): break size = int.from_bytes(data[offset + 8 : offset + 16], "big") header_size = 16
if size < header_size or offset + size > len(data): break
yield kind, offset, size, data[offset + header_size : offset + size] offset += size实际解析还需要进入子容器、区分轨道,并处理文件头尚未读完的情况。Box 的位置应由经过检查的长度逐段计算,不能搜索几个字符串后就假定找到了正确边界。
Sample 切分同样如此:一处长度错误会使后续读取错位。播放器最终表现为无声或解码失败,问题却可能出在更早的索引阶段。
CENC 与 Sample 辅助信息
CENC(Common Encryption)将受保护的媒体 Sample 与相应辅助信息关联起来。不同 Sample 可能有各自的初始化向量,也可能由保持原样的区域和需要处理的区域组成。
因此,处理前需要确认三组信息能够对齐:Sample 的数量、每个 Sample 的大小,以及它对应的辅助信息。处理过程中还要保持原有顺序。
本文不展开授权材料的获取或平台私有逻辑。对外层程序而言,重点是把边界检查和索引校验放在处理之前;信息不一致时应明确报错,而不是继续向播放器写入数据。
用缓冲区衔接网络与媒体边界
先下载完整文件再处理,适合早期验证,但播放前的等待会随文件大小增加。我随后把下载、处理和输出串成了流式管道。
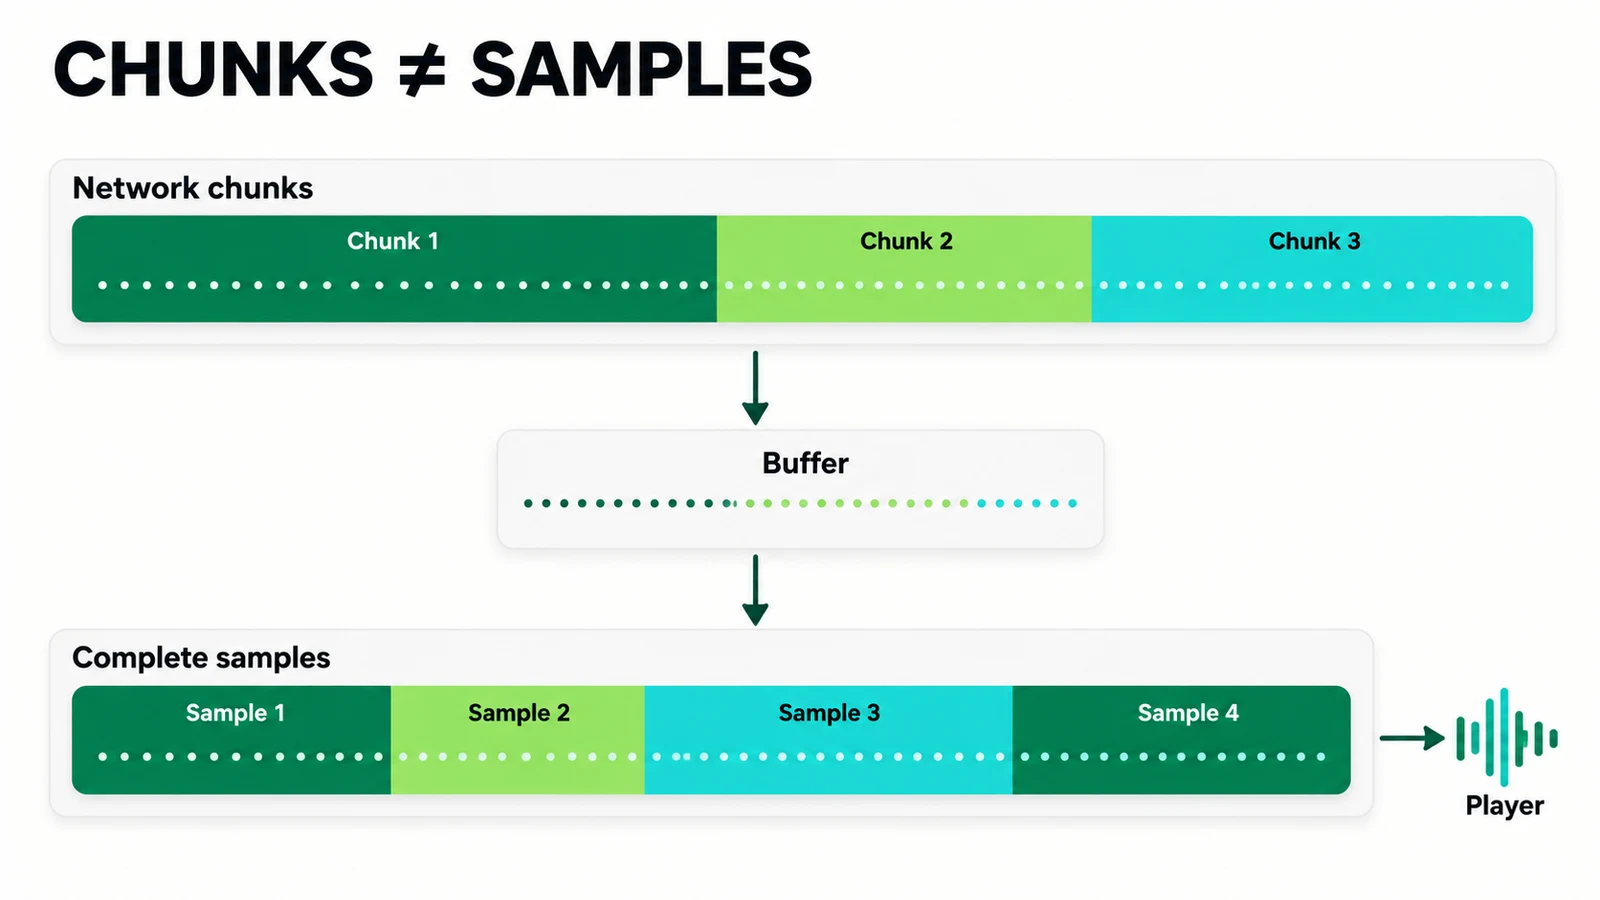
程序先收集足够的文件头,建立索引并确定数据区位置,再持续读取媒体数据。网络库每次提供的 Chunk 大小并不固定:可能只有半个 Sample,也可能一次带来两个半 Sample。
这里不能直接把 Chunk 当作一个处理单元。我的做法是在中间保留缓冲区,新字节到达后先追加进去;凑齐当前 Sample 需要的长度,才取出、处理并写入播放器。剩余字节留给下一轮。
pending = bytearray()sample_index = 0
for chunk in response.iter_bytes(): pending.extend(chunk)
while sample_index < len(sample_sizes): expected = sample_sizes[sample_index] if len(pending) < expected: break
sample = bytes(pending[:expected]) del pending[:expected]
frame = process_sample( sample, metadata=sample_metadata[sample_index], ) player.stdin.write(frame) sample_index += 1process_sample() 代表已获得授权的媒体处理过程,具体实现省略。这里展示的是外层缓冲逻辑:输入按网络到达顺序积累,输出按 Sample 索引逐个推进。
处理完的帧可以立即写入播放器的标准输入,不必再等整个文件下载结束。启动延迟仍受文件头探测、索引建立及首批 Sample 的处理耗时影响,需要结合实际运行测量。
检查 Range 请求的实际响应
从媒体数据区发起 Range 请求,可以避免再次读取已经解析过的文件头,但服务端不一定按预期返回区间内容。
实现时需要区分部分响应与完整响应。如果服务器忽略 Range、返回了完整文件,程序就要跳过前置字节;否则文件头也会混进后面的 Sample 数据里。这类问题应当在网络层处理,不要等播放器报错后再猜原因。
按编码格式组织输出
MP4 不等同于某一种音频编码。容器解析完成后,还需要读取编码配置,决定输出数据怎样组装。
AAC 的输出需要结合相应的编码配置;FLAC 也有自己的元数据和帧结构。有的情况适合保留容器,有的情况适合直接输出音频流,不宜用同一个分支处理所有格式。
我让解析层提供统一的轨道与编码信息,输出层再决定组装方式。这样扩展格式时,搜索和下载部分可以继续沿用。
把管道状态显示出来
下载还在继续,并不表示播放也在推进。文件头不完整、索引缺失、缓冲区数据不足、播放器退出,都可能让链路停在不同位置。
为方便排查,我把容器探测、Sample 索引、Range 通道、缓冲区、处理状态和播放器状态放进了同一个视图。
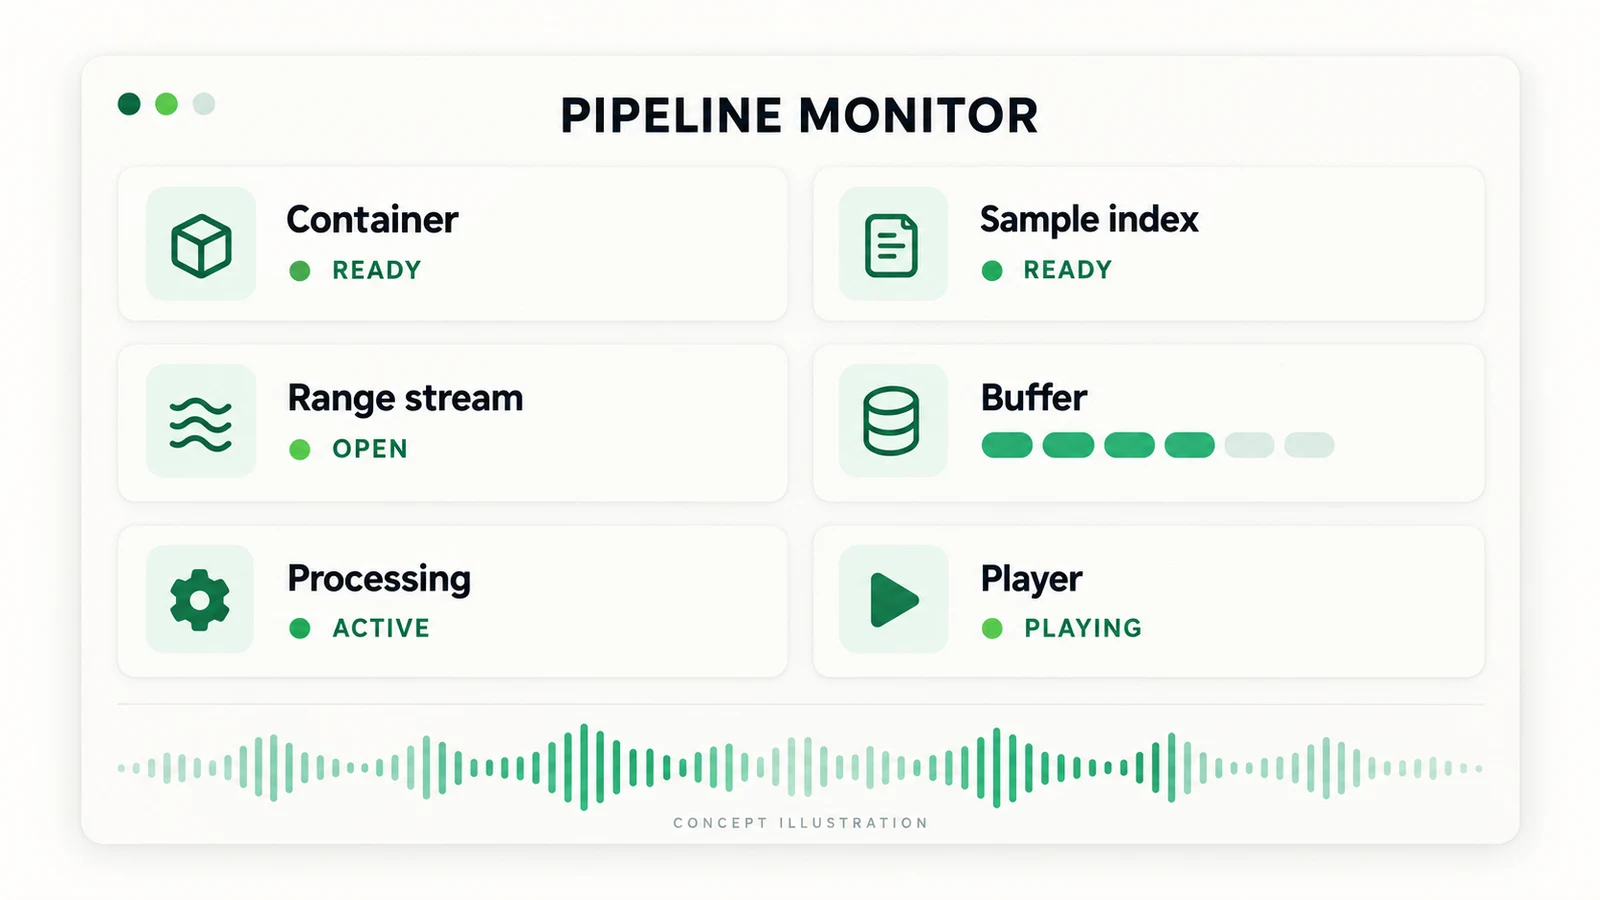
实际排查时,我会分别确认:
- 文件头是否收集完整,必要的 Sample 表是否存在。
- Sample 数量、大小和辅助信息是否匹配。
- 请求是否从正确的媒体数据位置开始读取。
- 缓冲区是在等待更多字节,还是已经有完整 Sample 没有被消费。
- 播放器是否仍在运行,标准输入管道是否可写。
停止流程也要一起考虑。用户停止播放、网络断开或播放器退出后,其他线程、请求和子进程都应随之收尾,不能只让界面回到“未播放”。
这条链路后面还有可以继续检查的地方,例如不完整文件头的恢复、异常容器的诊断,以及缓冲策略对播放延迟的影响。现阶段先把每一层的边界和状态处理清楚,再做进一步优化。
分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
最后更新于 ,距今已过 0 天
部分内容可能已过时